Confesso che per parecchio tempo, quando un agente di coding sbagliava in modo clamoroso, la mia reazione istintiva era prendermela con il modello, un po’ come chi dà la colpa al motore dopo aver dimenticato di togliere il freno a mano; poi, scrivendo e riscrivendo la guida pratica a Claude Code, ho dovuto ammettere che una parte consistente di quei disastri non dipendeva affatto dal cervello che stavo usando, ma dal corpo in cui lo avevo infilato, cioè da quello strato di software che gli passa gli strumenti, decide che cosa può fare senza chiedere e sceglie che cosa resta nella sua memoria a breve termine.
Quello strato ha un nome che negli ultimi mesi è passato dai blog degli addetti ai lavori alle slide dei convegni, ed è harness, letteralmente imbracatura o finimenti, la stessa parola che in inglese si usa per il cavallo da tiro e per chi si arrampica in parete. In questo articolo provo a raccontarti che cos’è un harness AI, come funziona il ciclo agentico che lo anima, che cosa distingue un harness buono da uno mediocre e come orientarti nella scelta dello strumento; ti avviso subito che il panorama cambia a una velocità imbarazzante e che i fatti che trovi qui sono stati verificati a ottobre 2026, quindi prendili come una fotografia e non come una scultura.
Il cervello e il corpo: che cos’è un harness
Partiamo da un’ovvietà che tendiamo a dimenticare appena apriamo il terminale: un modello linguistico, da solo, non apre file e non lancia test, perché riceve testo e produce testo, e tutto quello che sembra «fare» lo fa il programma che gli sta attorno. La documentazione di Anthropic lo dice senza giri di parole nella pagina How Claude Code works: Claude Code è lo strato attorno al modello che fornisce i tool e gestisce il contesto che il modello vede, ed è proprio a questo strato che si riferisce il termine agentic harness.
La metafora che uso nel libro, da non prendere troppo alla lettera, è quella del cervello e del corpo. Il modello è il cervello, che legge il contesto che gli viene passato, ragiona e decide quale passo fare e con quale strumento; l’harness è il corpo, con le mani e gli attrezzi, che costruisce il system prompt, mette a disposizione i tool e ne descrive l’uso, esegue materialmente le chiamate, applica i permessi e decide che cosa entra nella finestra di contesto e che cosa ne esce quando si riempie.
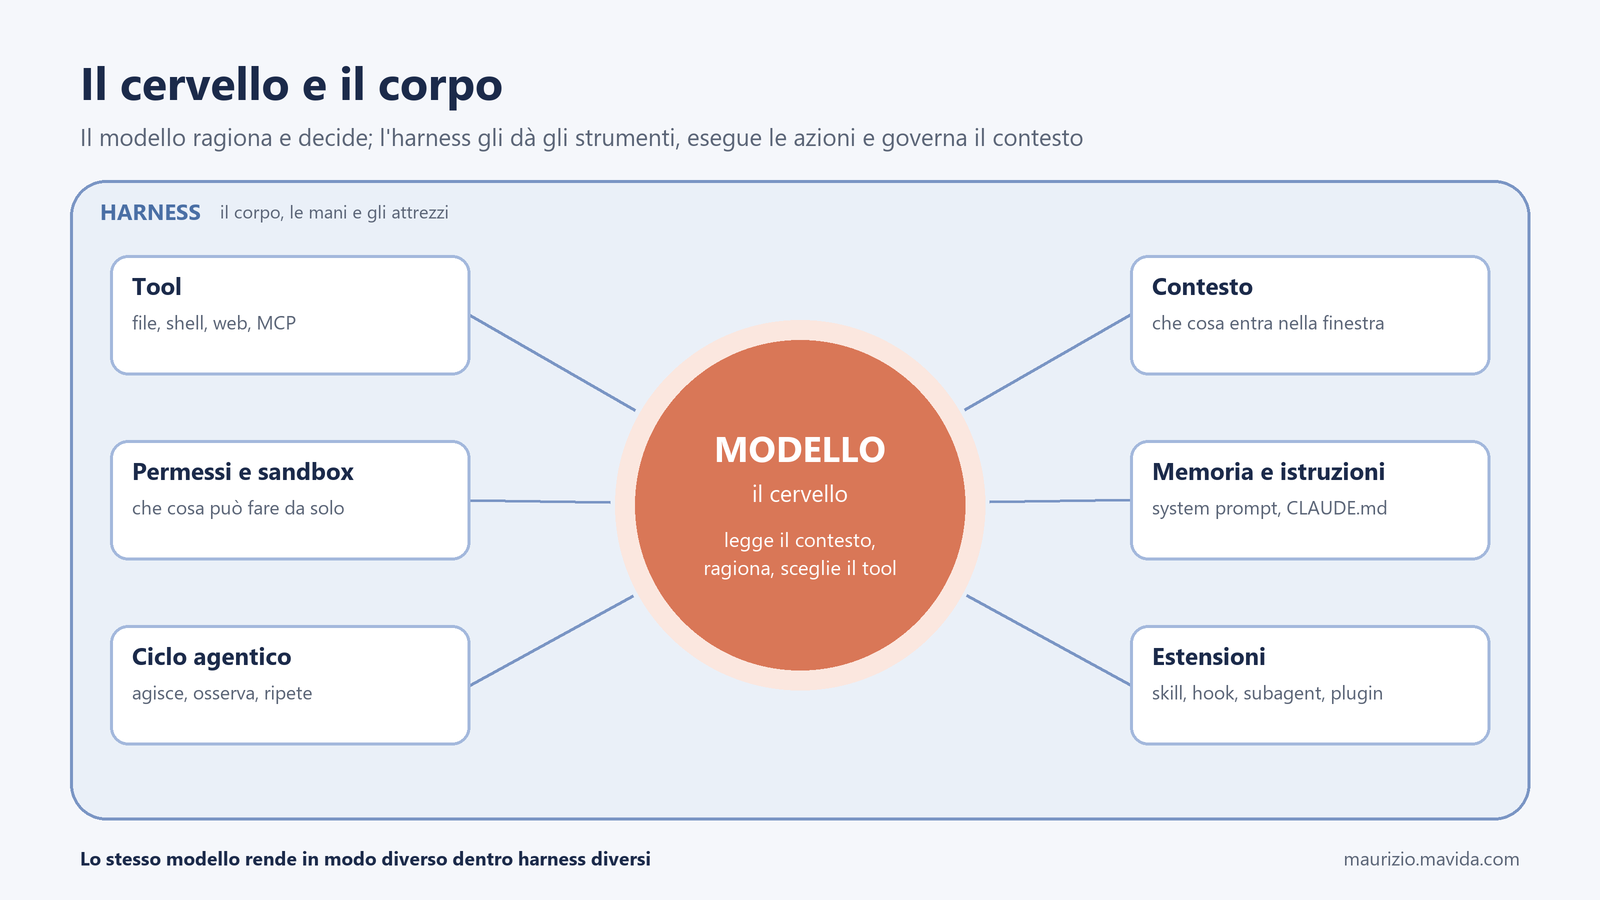
Da questa distinzione discende un fatto che spiazza chi arriva dalla chat, ovvero che lo stesso modello può dare risultati molto diversi in harness diversi, perché cambiano le istruzioni di sistema, l’elenco degli strumenti, le loro descrizioni, il modo in cui il contesto viene compattato e il punto in cui l’agente deve fermarsi a chiederti il permesso. Anthropic ne ha dato una misura concreta nell’articolo Writing effective tools for AI agents, dove racconta che Claude Sonnet 3.5 ha raggiunto lo stato dell’arte su SWE-bench Verified dopo una serie di ritocchi precisi alle descrizioni dei tool, senza cambiare di una virgola il modello, e già nel 2024, in Building effective agents, suggeriva di curare l’interfaccia tra agente e computer quanto quelle pensate per gli esseri umani.
Quando dici che «l’AI» ha sbagliato, in realtà stai giudicando una coppia: un cervello e il corpo in cui l’hai messo, e a volte il problema non sta nella testa ma nelle mani.
Lo stesso Claude Code adatta il corpo al cervello: gli strumenti per tenere una lista di attività, come TaskCreate, sono attivi di default solo sui modelli fino a Opus 4.7 e Sonnet 4.6 e su Haiku 4.5, perché i modelli più recenti seguono il lavoro in più passi senza una checklist scritta, e le definizioni dei tool occupano contesto prezioso.
Il ciclo agentico di un harness
Il cuore di ogni harness è un ciclo, che la documentazione riassume in tre fasi intrecciate, cioè raccogliere il contesto, agire e verificare i risultati, e che per chi lo osserva da fuori conviene scomporre in sei passi un po’ più espliciti:
- Obiettivo: descrivi che cosa vuoi ottenere.
- Raccolta del contesto: l’agente cerca i file pertinenti, li legge, consulta
CLAUDE.mde l’output dei comandi. - Piano: decide la sequenza dei passi, in modo implicito oppure, in Plan Mode, esplicito e sottoposto alla tua approvazione.
- Azione tramite tool: modifica un file, lancia un comando, interroga un servizio.
- Osservazione: legge il risultato dell’azione, cioè l’output dei test, l’errore del compilatore o la risposta di un’API.
- Iterazione: corregge la rotta e riparte, finché il task non è concluso o non serve una tua decisione.
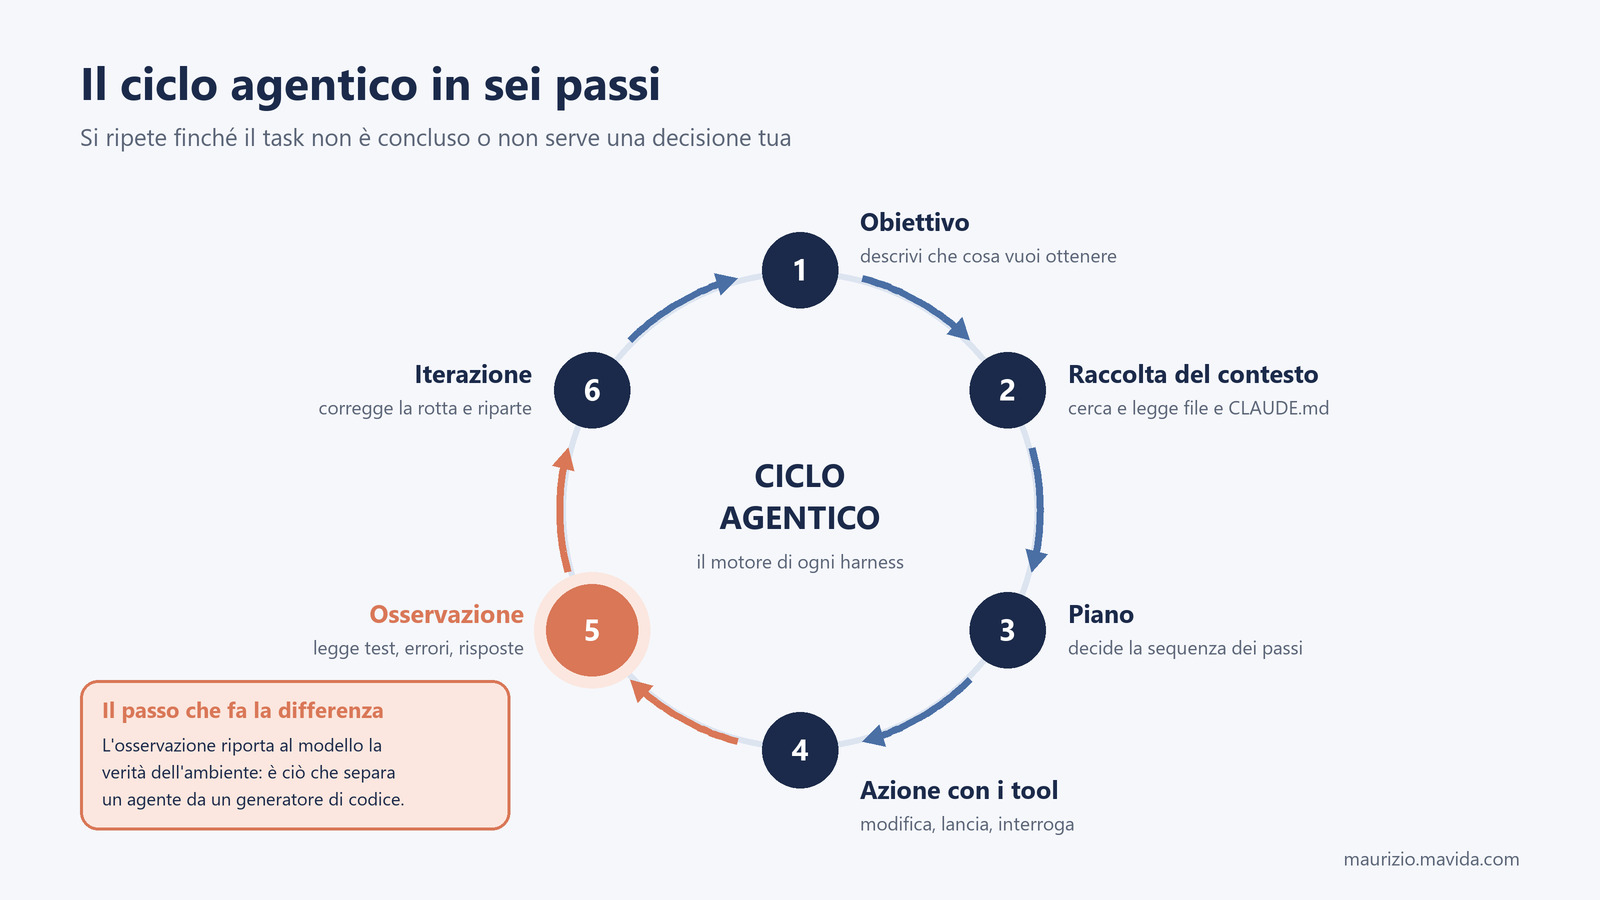
Il passo che fa davvero la differenza è il quinto, perché è quello che separa un agente da un generatore di codice che scrive file e spera per il meglio: Anthropic insiste sul fatto che l’agente debba ricevere a ogni giro una ground truth dall’ambiente, ed è per questo che conta tantissimo che l’harness sappia far girare test e build e restituirne l’esito al modello. Tu, nel frattempo, resti dentro il ciclo e puoi interromperlo con Esc, cosa molto rassicurante quando lo vedi puntare con grande decisione verso la cartella sbagliata.
Un harness fatto in casa: Hernesto
Il modo migliore che conosco per capire quanto lavoro faccia un harness è provare a scriverne uno, ed è quello che ho fatto con Hernesto, un agente da terminale in Python che trovi su GitHub nel repository mavidasnc/hernesto: è nato come una semplice CLI per chattare con i modelli tramite OpenRouter e, un’aggiunta dopo l’altra, è diventato un piccolo harness completo, con il suo ciclo agentico, i suoi strumenti e le sue regole.
Il cuore è proprio il ciclo descritto sopra: il modello riceve la conversazione e l’elenco dei tool, chiede di usarne uno, Hernesto lo esegue e gli restituisce il risultato, e si ricomincia finché non arriva la risposta finale. Gli strumenti sono quelli che ti aspetteresti, cioè leggere, cercare, scrivere e modificare file, lanciare comandi di shell, cercare sul web e scaricare pagine, a cui si aggiungono la posta via IMAP, l’invio di email, i messaggi Telegram e, se servono, i server MCP; il contesto si costruisce con alcuni file Markdown letti all’avvio, una sorta di CLAUDE.md fatto in casa che separa il carattere dell’agente dalle istruzioni operative, mentre skill e playbook caricano conoscenze e procedure solo quando servono.
La parte che mi ha insegnato di più, però, è tutto quello che sta attorno al ciclo, che in un prototipo da laboratorio semplicemente non esiste: i percorsi dei file sono confinati nella cartella di lavoro, i comandi pericolosi passano da una lista di pattern che fa scattare una conferma, l’invio di email e lo spostamento nel cestino chiedono sempre il permesso, il contenuto delle email arriva al modello incorniciato come testo di terzi e non come istruzioni, e ogni sessione ha un tetto di spesa che protegge il portafoglio anche quando le conferme sono disattivate. Il README lo dice con onestà: run_command non ha un vero sandbox, e la conferma è una difesa contro la disattenzione, non contro un modello che voglia eluderla.
È esattamente la distinzione tra regole di permesso e sandbox del sistema operativo di cui parlo nella prossima sezione, vissuta sulla propria pelle: scrivere Hernesto mi ha convinto che il modello, per quanto bravo, è la parte più piccola del lavoro, e che la differenza la fanno le scelte noiose sul contesto, sui permessi e sui confini. Se vuoi curiosare nel codice o usarlo come base per il tuo esperimento, il repository è pubblico; se invece cerchi un punto di partenza più robusto per un prodotto, l’Agent SDK di Anthropic offre in Python e TypeScript lo stesso ciclo e gli stessi tool di Claude Code.
Che cosa rende buono un harness
Se l’harness è il corpo, come si riconosce un corpo in buona salute? Nel libro propongo quattro criteri validi per qualunque strumento, Claude Code compreso: permessi, sandbox, gestione del contesto ed estensibilità.
Permessi e sandbox non sono la stessa cosa
La prima distinzione, che vale oro quando lasci un agente lavorare da solo, è quella tra regole di permesso e sandbox. Le regole decidono quando l’harness ti chiede conferma: Claude Code ha sei modalità di permesso e regole allow, ask e deny per tool e pattern, e dalla v2.1.284 le sessioni interattive partono in auto mode, con un classificatore che blocca le azioni rischiose. Il sandbox, invece, è un recinto imposto dal sistema operativo, che vale anche quando il modello lancia un comando che le regole non avevano previsto: Claude Code usa Seatbelt su macOS e bubblewrap su Linux e WSL2, mentre sul Windows nativo il sandbox non è supportato. Un harness può avere regole eccellenti e nessun sandbox, e la differenza si nota sempre nel momento meno opportuno.
Contesto ed estensibilità
Il terzo criterio è la gestione del contesto, perché quando la finestra si avvicina al limite qualcuno deve decidere che cosa sacrificare: Claude Code elimina prima gli output dei tool più vecchi e poi riassume la conversazione, con il rischio che le istruzioni date all’inizio vadano perse, ed è per questo che le regole durature vanno scritte in CLAUDE.md, che l’harness inietta in ogni sessione, invece di affidarle alla cronologia della chat. Il quarto criterio è l’estensibilità, che in Claude Code passa per skill, server MCP, subagent, hook e plugin.
Se rileggi l’elenco ti accorgi di una cosa curiosa, cioè che quasi tutte le leve che hai in mano quando lavori con Claude Code, dai permessi a CLAUDE.md, dalle skill ai server MCP fino ai subagent, non agiscono sul modello, ma sull’harness, e questo spiega perché due persone con lo stesso abbonamento e lo stesso modello possano ottenere risultati lontanissimi: non hanno cervelli diversi, hanno costruito corpi diversi.
Per curiosità sono andato a sbirciare dentro DeepSeek Harness (dsh), l’harness open source con licenza MIT sviluppato da DeepSeek, che non trovi nel libro e che il README descrive come un’architettura in cui «tutto è un plugin», dichiarandolo in developer preview e avvisando, rigorosamente in maiuscolo, che arriveranno cambiamenti incompatibili; si prova con un semplice npx @deepseek-ai/dsh web, che avvia un’interfaccia web in locale. La parte più istruttiva, però, è l’elenco dei pacchetti, che sembra la mappa anatomica di questo articolo: sessione, system prompt, tool, ciclo agentico, shell, filesystem, compattazione del contesto, skill e subagent, ciascuno come capacità separata e sostituibile.
Dall’harness engineering al loop engineering
In pochi anni abbiamo visto passare una serie di etichette che finiscono tutte con «engineering», e la tentazione di liquidarle come mode da LinkedIn è forte; sotto le etichette, però, c’è uno spostamento reale del punto in cui lo sviluppatore mette il proprio lavoro, e il modo più utile di leggerlo è come una serie di strati che si sommano, non di fasi che si danno il cambio.
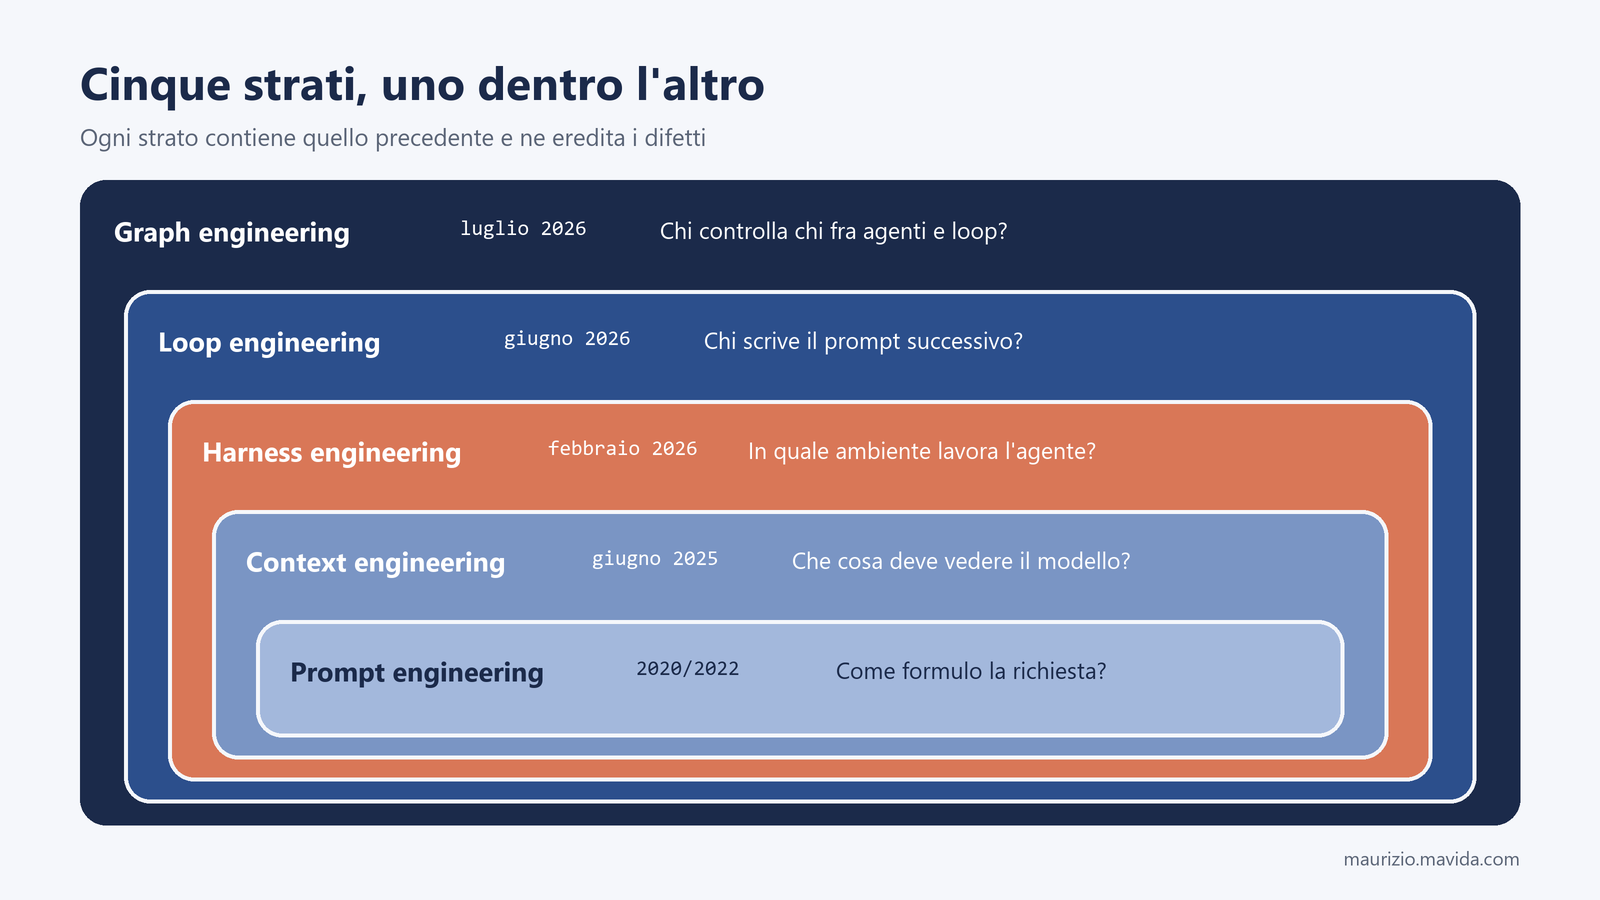
Il prompt engineering, affermatosi tra il 2020 e il 2022, si chiede come formulare la richiesta, e ne ho parlato nell’articolo su prompt engineering e vibe coding consapevole; il context engineering, da giugno 2025, si chiede che cosa deve vedere il modello a ogni turno. L’harness engineering arriva a febbraio 2026, quando Mitchell Hashimoto racconta in My AI Adoption Journey la regola che chiama engineering the harness e, nello stesso mese, OpenAI pubblica un resoconto intitolato proprio Harness engineering: la domanda diventa dentro quale ambiente lavora l’agente, con quali tool, permessi e verifiche.
La regola di Hashimoto, in sintesi, è disarmante: ogni volta che l’agente commette un errore, investi il tempo necessario perché non lo commetta mai più, con istruzioni persistenti e strumenti che gli permettano di verificarsi da solo.
Sopra l’harness, a giugno 2026, arriva il loop engineering, a cui Addy Osmani ha dato un nome nell’articolo Loop Engineering: lo sviluppatore non dialoga più turno per turno, ma progetta il sistema che genera il prompt successivo, l’innesco e una condizione di arresto verificabile da una macchina. In cima, da luglio 2026, c’è il graph engineering, il termine più giovane e più fragile, che riguarda le reti di agenti e di loop che si controllano a vicenda; l’etichetta potrebbe sgonfiarsi presto, ma il problema di coordinare più agenti senza perdere il controllo resterà.
La lezione pratica è che nessuno strato rende inutile quello sottostante, anzi ne eredita i difetti: un loop costruito su un contesto confuso ripete la confusione a ogni giro. Prima di inseguire l’ultima etichetta conviene chiedersi se il proprio harness regge, cioè se l’agente ha le istruzioni giuste e un modo affidabile per accorgersi di avere sbagliato.
Come scegliere l’harness senza farsi travolgere
La domanda inevitabile è quale harness usare, e la risposta onesta è che un vincitore assoluto non esiste, perché buona parte del risultato la fa il modello e perché i principali strumenti si avvicinano così in fretta, con gli stessi standard e perfino comandi per importare l’uno la configurazione dell’altro, che le differenze funzionali di oggi possono sparire alla prossima release. Le differenze strutturali, invece, tendono a restare, ed è su quelle che conviene ragionare:
- Claude Code di Anthropic funziona solo con i modelli Claude e ha codice chiuso, ma offre il sistema di estensione più completo e integrato, un sandbox con controllo della rete su macOS, Linux e WSL2 e lo stesso motore su terminale, IDE, desktop e web: è la scelta naturale se hai già scelto Claude.
- OpenAI Codex, nella versione CLI, è open source con licenza Apache 2.0 e scritto in Rust, ammette provider di terze parti e modelli locali e documenta un sandbox anche su Windows nativo, con la rete disattivata per default: ha senso se lavori con i modelli OpenAI o hai già un abbonamento ChatGPT.
- OpenCode di Anomaly, con licenza MIT e scritto in TypeScript, è agnostico rispetto al fornitore e supporta oltre 75 provider e modelli locali, ma ha default permissivi e nessun sandbox documentato, e con Claude funziona solo tramite API key.
Una notizia di questa primavera vale più di qualunque tabella comparativa: Roo Code, un fork di Cline arrivato a tre milioni di installazioni, ha chiuso estensione, cloud e router il 15 maggio 2026, e ha archiviato il repository, costringendo chi ci aveva costruito sopra il proprio flusso di lavoro a traslocare da un giorno all’altro. È il promemoria più concreto del rischio di legarsi mani e piedi a un singolo harness, e del motivo per cui conviene investire nelle cose che sopravvivono al cambio di strumento.
Istruzioni portabili: AGENTS.md e CLAUDE.md
La prima di queste cose sono le istruzioni. AGENTS.md è il file letto nativamente da Codex e da OpenCode, e dalla v2.1.277 anche da Claude Code, che però per default lo legge solo quando non trova alcun CLAUDE.md; la strategia più ragionevole per un repository usato con più harness è quindi mettere le istruzioni condivise, come stack, comandi, convenzioni e regole invalicabili, in AGENTS.md, e tenere un CLAUDE.md breve che importa @AGENTS.md e aggiunge solo ciò che è specifico di Claude Code.
La documentazione di Anthropic sconsiglia su Windows la scorciatoia del collegamento simbolico tra i due file, e il caso ha voluto che proprio il repository di DeepSeek Harness me ne desse una dimostrazione dal vivo: lì CLAUDE.md è un collegamento simbolico ad AGENTS.md, e clonandolo sul mio portatile Windows mi sono ritrovato con un CLAUDE.md che conteneva soltanto la parola «AGENTS.md», istruzione impeccabile dal punto di vista filosofico ma piuttosto avara di dettagli per un agente. L’import esplicito, in confronto, è noioso, ma funziona ovunque.
Il resto della ricetta è altrettanto poco glamour: test che fanno da guardrail, server MCP che qualunque harness può usare, skill nel formato SKILL.md. Scegli l’harness come sceglieresti un editor o un sistema di build, cioè in base ai vincoli reali (modelli, licenza, dati, piattaforma e contratti) e non in base all’ultimo annuncio, provalo sui tuoi task con il modello che userai davvero e diffida dei confronti che non dicono quale modello e quale livello di ragionamento sono stati usati.
Tirando le somme
Se dovessi riassumere tutto in una frase direi che, quando lavori con un agente di coding, non stai usando un modello ma una coppia formata da un cervello e da un corpo, e che il corpo è la parte su cui hai più controllo: puoi scegliere l’harness, configurarne i permessi, scrivergli istruzioni chiare, dargli test con cui verificarsi e strumenti con cui agire, e ogni ora investita lì rende più di qualunque discussione su quale sia il modello più intelligente della settimana. Ricorda però che nomi, versioni e date di questo articolo sono una fotografia di ottobre 2026: ricontrolla le fonti prima di decidere.
Se vuoi approfondire, nella guida pratica a Claude Code, che è gratuita e si scarica senza lasciare indirizzi email, trovi la sezione 1.6 su modello e harness, la sezione 1.7 sugli strati dell’engineering e il capitolo 16, che mette Claude Code a confronto con Codex, OpenCode e il resto del panorama; le novità dell’ultima edizione sono raccontate nell’articolo sulla versione 6.1, mentre se parti da zero ti consiglio di cominciare dalla presentazione della guida, e altri articoli sull’AI applicata allo sviluppo li trovi nella categoria Intelligenza artificiale. E se nel tuo team state valutando come portare questi strumenti nel lavoro di tutti i giorni senza improvvisare, possiamo parlarne con calma in una call conoscitiva.
Nel frattempo mi piacerebbe sapere quale harness usi e se ti è mai capitato di dare la colpa al cervello quando il problema stava nelle mani: raccontamelo nei commenti, e se l’articolo ti è stato utile condividilo con un collega o sul tuo profilo LinkedIn, magari dedicandolo a quella persona che continua a sostenere che «tanto l’AI sbaglia sempre».