

Questo articolo è stato pubblicato per la prima volta nel 2006 e completamente riscritto a ottobre 2026: i commenti più vecchi si riferiscono alla versione originale.
Nel giugno del 2006 questo blog aveva un problema che oggi suona quasi tenero: una buona parte della banda se ne andava tra spam crawler e siti che mostravano le mie immagini caricandole direttamente dal mio server. La soluzione era un paio di file .htaccess con mod_setenvif, uno per bloccare le immagini richieste da altri domini e uno con una piccola lista nera di indirizzi IP compilata a mano partendo dai commenti di spam, che chiudevo, con l’ottimismo dell’epoca, definendo tutto questo «solo un antipasto».
Vent’anni dopo l’antipasto è diventato un pranzo di nozze. L’hotlinking esiste ancora, ma pesa meno, mentre i bot si sono moltiplicati e, soprattutto, sono arrivati i crawler AI, alcuni dei quali raccolgono contenuti per addestrare i modelli e altri li leggono per citarti nelle risposte dei motori di ricerca generativi. In questo articolo vediamo come proteggere banda e contenuti nel 2026: hotlinking lato server e CDN, rate limiting per i bot troppo voraci e un robots.txt che distingue chi vuoi far entrare da chi preferisci tenere fuori.
Hotlinking: cos’è e come bloccarlo oggi
L’hotlinking è l’abitudine di altri siti di mostrare le tue immagini inserendo nel loro HTML l’indirizzo del file sul tuo server: tu paghi la banda, loro incassano le visite. Si blocca controllando l’header Referer della richiesta, che indica la pagina da cui arriva, e negando l’accesso alle immagini quando il dominio non è il tuo, lasciando però passare le richieste senza Referer, perché molti browser, app e proxy non lo inviano.
Su Apache e LiteSpeed oggi uso mod_rewrite invece dei vecchi Order e Allow del 2006, che in Apache 2.4 sono stati sostituiti da Require; ricordati di aggiungere i formati moderni come WebP e AVIF, che nel 2006 non esistevano:
# .htaccess: niente immagini ai siti esterni, sì a richieste senza Referer
RewriteEngine On
RewriteCond %{HTTP_REFERER} !^$
RewriteCond %{HTTP_REFERER} !^https://(www\.)?example\.com/ [NC]
RewriteRule \.(gif|jpe?g|png|webp|avif)$ - [F,NC]
Su nginx lo stesso risultato si ottiene con il modulo referer, dichiarando quali Referer sono validi:
location ~* \.(gif|jpe?g|png|webp|avif)$ {
    valid_referers none blocked server_names *.example.com;
    if ($invalid_referer) {
        return 403;
    }
}
Hotlink protection lato CDN
Se il sito passa da Cloudflare, la funzione Hotlink Protection fa lo stesso lavoro al bordo, senza toccare il server, ma secondo la documentazione ufficiale si applica solo ai file gif, ico, jpg, jpeg e png, e impedisce la visualizzazione delle immagini anche su servizi come Google Immagini, Pinterest e Facebook. Le immagini che vuoi lasciare condivisibili possono stare in una cartella chiamata hotlink-ok, che Cloudflare esclude dal controllo. Prima di attivarla chiediti quindi se quelle visualizzazioni esterne ti portano traffico, perché spesso valgono più dei byte risparmiati.
Bot aggressivi e rate limiting
Un bot aggressivo è un programma che scarica pagine a un ritmo tale da appesantire il server, che sia uno scraper, un tool SEO mal configurato o un crawler che ignora ogni regola. La difesa moderna non è più la lista nera di IP che compilavo nel 2006, inutile contro reti che cambiano indirizzo di continuo, ma il rate limiting: si stabilisce quante richieste al minuto sono ragionevoli per un singolo client e si rallenta o si blocca chi le supera.
Il posto migliore dove applicarlo è la CDN o il web server, prima che le richieste arrivino a PHP; gli stessi meccanismi che uso per proteggere il login, dal limit_req di nginx alla regola di rate limiting di Cloudflare, li trovi descritti nell’articolo su come proteggere il login di WordPress dal brute force. Le aree che meritano più attenzione sono la ricerca interna, i filtri dei negozi e i feed, perché ogni richiesta genera query costose.
C’è poi un dettaglio che vale per tutte le regole basate sullo user agent: dichiararsi Googlebot non costa nulla, e molti scraper lo fanno. Google documenta come verificare i suoi crawler con il DNS inverso e con gli elenchi di IP pubblicati, e anche le principali CDN distinguono i bot verificati da quelli che si limitano a usare un nome rassicurante; prima di bloccare o lasciar passare qualcuno in base al nome, quindi, controlla da dove arriva davvero.
Crawler AI: addestramento contro ricerca
I crawler AI si dividono in due famiglie che conviene trattare in modo diverso: quelli di addestramento, che raccolgono contenuti per allenare i modelli, e quelli di ricerca, che leggono le pagine per mostrarle e citarle nelle risposte dei motori AI. Bloccare i primi non ti toglie dalle risposte di ChatGPT, Claude o Google; bloccare i secondi sì.
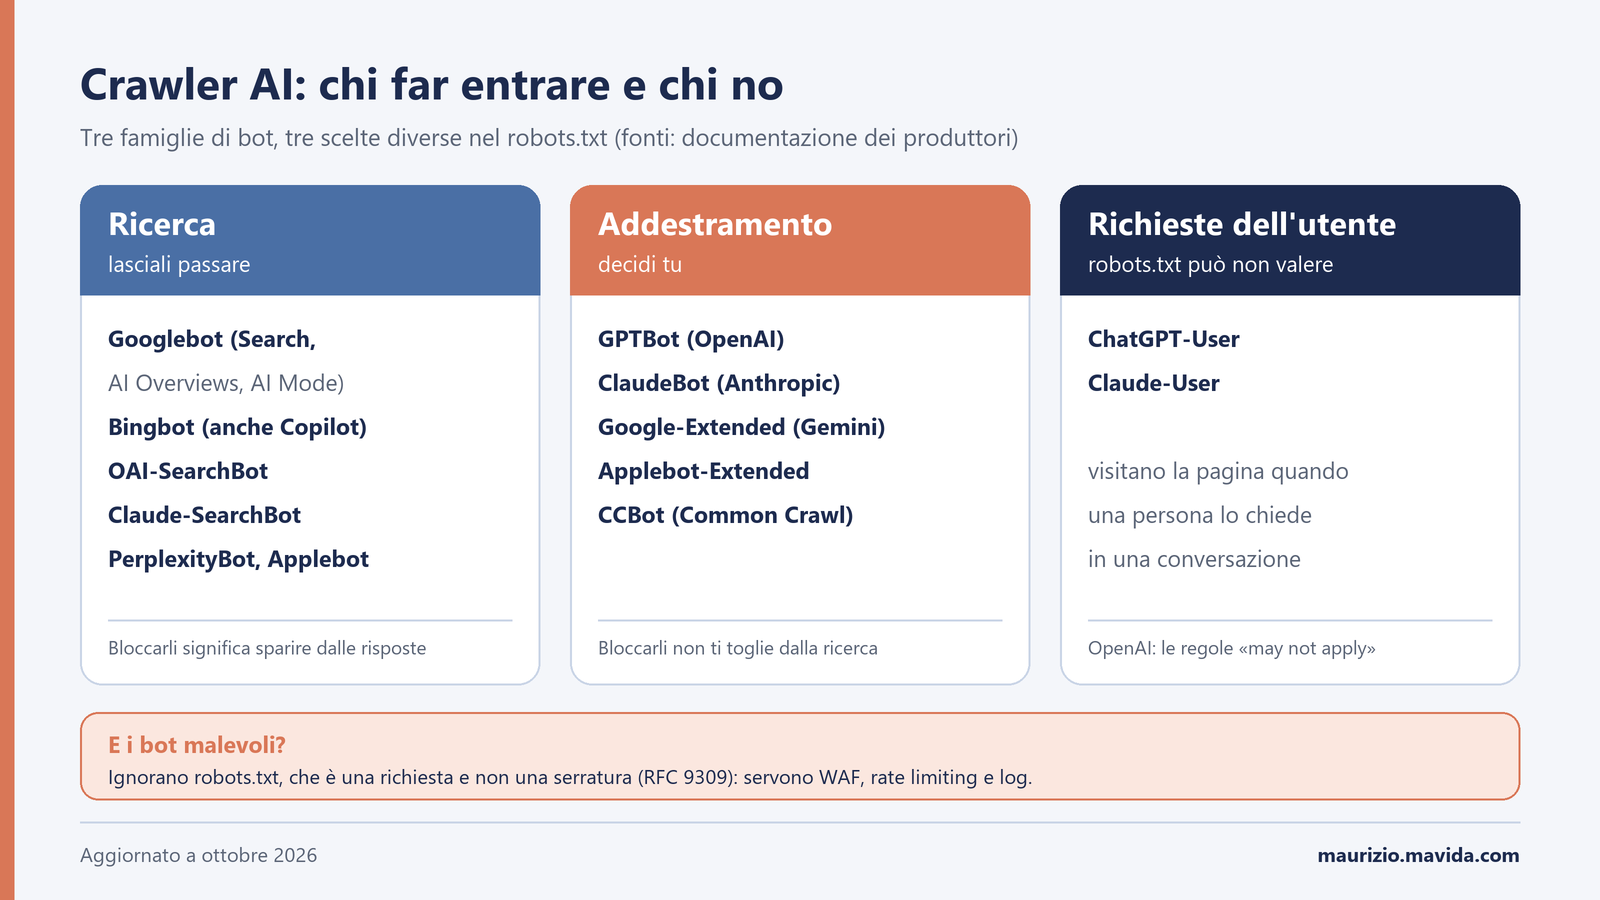
I nomi da conoscere, secondo la documentazione dei rispettivi produttori, sono questi:
- Addestramento:
GPTBotdi OpenAI,ClaudeBotdi Anthropic, il tokenGoogle-Extendeddi Google per l’addestramento e il grounding di Gemini,Applebot-Extendeddi Apple eCCBotdi Common Crawl, il cui dataset aperto viene riusato anche per addestrare modelli. - Ricerca:
Googlebot, che alimenta Google Search comprese AI Overviews e AI Mode,Bingbot, che serve anche Copilot,OAI-SearchBotper la ricerca di ChatGPT,Claude-SearchBot,PerplexityBoteApplebot. - Richieste dell’utente:
ChatGPT-UsereClaude-User, che visitano una pagina quando un utente lo chiede esplicitamente durante una conversazione.
Su Google c’è un equivoco da sfatare: Google-Extended non influisce sull’inclusione in Google Search né sul ranking, e non toglie i tuoi contenuti dalle AI Overviews, che usano l’indice di Googlebot. Bloccare Googlebot per uscire dalle risposte AI significa, in pratica, uscire da Google.
Un robots.txt per il 2026
Questa è la policy che consiglio come punto di partenza a chi vuole restare visibile nella ricerca, anche AI, senza cedere i contenuti all’addestramento; ricordati che un gruppo dedicato a un bot sostituisce le regole di User-agent: *, quindi i Disallow comuni vanno ripetuti in ogni gruppo:
# Ricerca: lasciare passare (bloccare Googlebot = uscire da Google)
User-agent: Googlebot
User-agent: Bingbot
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Applebot
Allow: /
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

# Addestramento dei modelli: no
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /

# Tutti gli altri
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://www.example.com/sitemap_index.xml
Se invece ti fa piacere che i tuoi contenuti contribuiscano all’addestramento, basta sostituire Disallow: / con Allow: / nel secondo gruppo: non esiste una scelta giusta in assoluto, esiste una scelta consapevole.
Cosa rispetta robots.txt e cosa no
robots.txt è una richiesta, non una serratura: lo standard RFC 9309 dice esplicitamente che le sue regole non sono una forma di autorizzazione all’accesso, e i crawler sono soltanto invitati a rispettarle. I bot dei grandi operatori lo fanno, quelli malevoli no, e per questi ultimi l’unica risposta efficace resta il blocco a livello di server o di CDN.
Anche tra i bot «educati» ci sono differenze che vale la pena conoscere:
- Le richieste avviate dall’utente possono non seguire le regole: OpenAI scrive che per
ChatGPT-Userle regole di robots.txt potrebbero non applicarsi, proprio perché l’azione nasce da una persona. - Crawl-delay non è universale: Anthropic dichiara di supportarlo per i suoi bot, mentre Google lo ignora del tutto; per rallentare Googlebot servono altri strumenti.
- Bloccare la scansione non deindicizza: Google può comunque mostrare un URL bloccato se lo trova linkato altrove; per uscire dall’indice serve un
noindexsu una pagina che il crawler può leggere. - Bloccare gli IP non basta per un opt out: Anthropic fa notare che, se blocchi gli indirizzi, il bot non riesce nemmeno a leggere il tuo robots.txt.
Il robots.txt è il cartello «vietato l’ingresso ai non addetti»: funziona benissimo con chi sa leggere ed è educato, per tutti gli altri serve una porta.
Per vedere chi rispetta davvero le tue regole, i log del server restano la fonte più onesta; se usi Cloudflare, la funzione AI Crawl Control, disponibile su tutti i piani, mostra l’attività dei crawler AI e quali seguono le direttive del tuo robots.txt, permettendo di bloccare chi non lo fa. Allinea sempre le regole della CDN a quelle del robots.txt, come racconto nell’articolo sulle CDN per WordPress, altrimenti rischi di dire «entra» in un posto e di chiudere la porta in un altro.
Tirando le somme
Nel 2026 proteggere la banda significa soprattutto scegliere chi far entrare: hotlink protection sul server o sulla CDN, ricordando i formati moderni e il valore delle condivisioni esterne; rate limiting al bordo per i bot troppo voraci, invece delle liste nere compilate a mano; e un robots.txt che separa i crawler di ricerca, da lasciar passare, da quelli di addestramento, su cui decidi tu. Il tutto sapendo che robots.txt è un accordo tra gentiluomini e che per chi non lo rispetta servono regole vere.
Per approfondire ti consiglio le pagine ufficiali di OpenAI sui suoi crawler, il documento di Google sui crawler comuni e lo standard RFC 9309; se il rapporto tra contenuti e intelligenza artificiale ti incuriosisce, trovi altri articoli nella categoria intelligenza artificiale. Raccontami nei commenti quale scelta hai fatto per i crawler di addestramento e perché, e se l’articolo ti è stato utile condividilo con chi ha ancora nel robots.txt solo le due righe di default.
E se preferisci non fare tutto da solo, puoi prenotare una call conoscitiva gratuita oppure scrivermi passando dalla pagina dei contatti: ne parliamo con calma, partendo dal tuo sito e non da una checklist generica.


interessantissima questa cosa.
mi paicerebbe inserirla nel mio blog. basta copiace il codice modificando i parametri?
bosogna inserirlo nella root delel imamgini oppur anche nella sub?
grazie
va inserito in ogni directory in cui ci sono immagini a cui non si vuole permettere la visualizzazione da altri referer.
tecnicamente puoi copiare lo script ma fai attenzione agli spazi che ho messo per poterlo pubblicare.
molto interessante anche il tutorial che ho linkato.
un ultima cosa: verifica che il tuo apache abbia il modulo setenvif installato.